分享一份台积电陆博士关于先进技术设计方案的一些观点。
陆博士 2000 年加入台积电,2018 年起掌管设计与技术平台部门。他跟制程研发团队合作搞出了设计与技术协同优化(DTCO)。
关于 DTCO 我们在之前的文章Acacia/思科:高速光模块 DTCO 与 STCO 协同优化方案聊过一些。
陆博士的观点主要围绕先进 DTCO、封装创新、AI 设计方法三个关键点。核心观点是,AI 和高性能计算时代,设计必须与制程深度绑定,加上系统集成,摩尔定律才能继续推进。
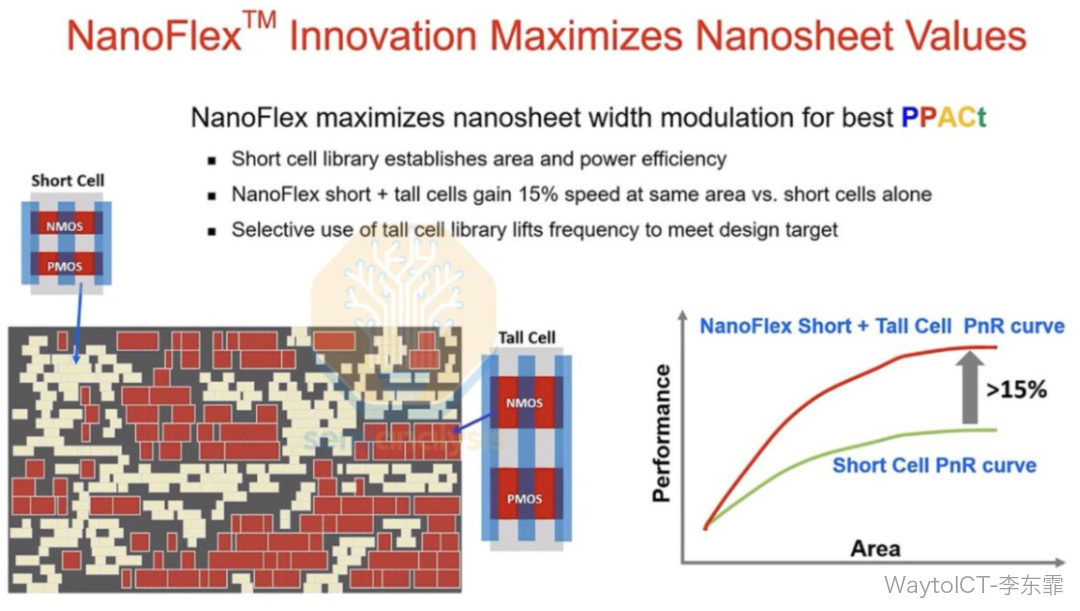
器件和设计端,台积电依靠 DTCO 和 DDCL,从 N5 推进到 N2 再到 A14。NanoFlex 和 NanoFlex Pro 优化了标准单元设计,提升了能效。N2 的 NanoFlex 与传统单元比:电压不变时,速度最高提升 50%;性能不变时,功耗最高降低 50%。
A14 的 NanoFlex Pro 采用 1.5 倍单元高度的合并氧化扩散层架构,互连层利用率更高,高低速单元紧凑排布。与 N2 比,速度提升 10% 到 15%,面积缩小约 20%。一代制程就获得了跨代收益。
N2P 和 N2U 继续优化 DTCO 和供电方案。混合双轨架构将最低工作电压拉低 200 毫伏以上,能耗降低约 40%。N2U 在 N2P 基础上性能提升 3% 到 4%,或功耗降低 8% 到 10%,且兼容现有设计规则和 IP,客户迁移几乎无感知。
制程和单元优化后,EDA 工具也必须跟上。台积电与 EDA 厂商配合完成工具适配,AI 设计流程已落地。智能体 AI 运行在全流程中,负责布局、布线、性能调优,兼顾效率和质量。模拟和射频设计也在用这套方法,跨制程迁移更快,上市周期缩短。
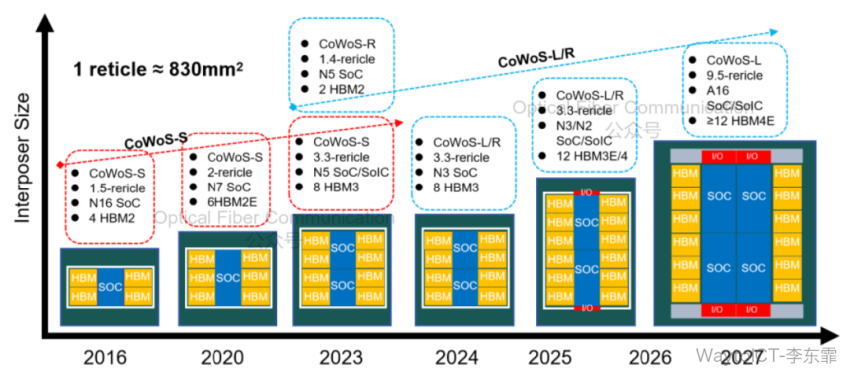
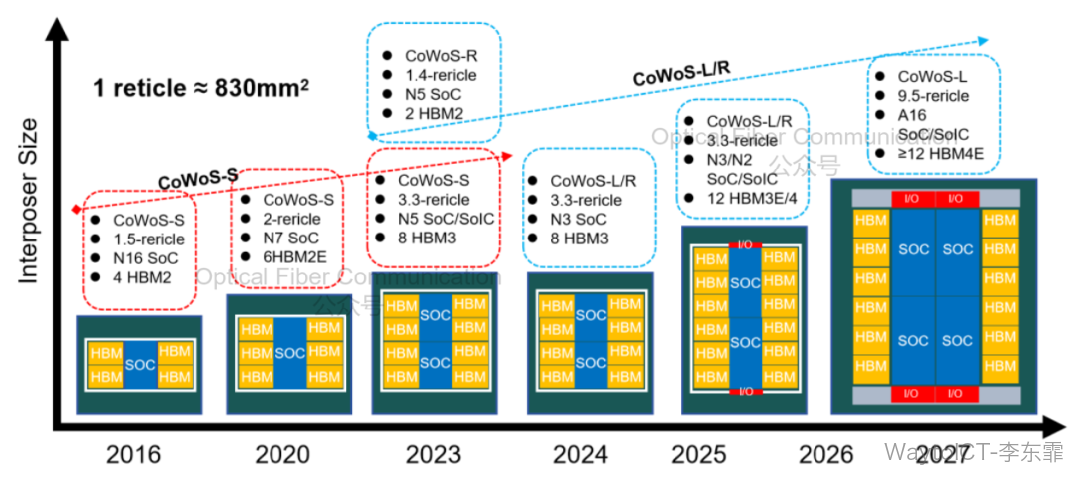
系统级封装方面,CoWoS、SoIC 和 3D Fabric 是 AI 算力扩容的主力。CoWoS 掩模尺寸和集成规模不断扩大,计算密度大幅提升。
2024 到 2029 年,单个 CoWoS 系统的晶体管数量预计增长 48 倍,得益于封装扩容、芯片集成量增加以及 A14 等新制程。
算力提升的同时,内存带宽也必须跟上。HBM 堆叠层数从 8 层向 24 层发展,单堆 I/O 带宽翻倍,整体带宽增长 34 倍。这背后是 DRAM 技术迭代和先进制程逻辑基片升级。
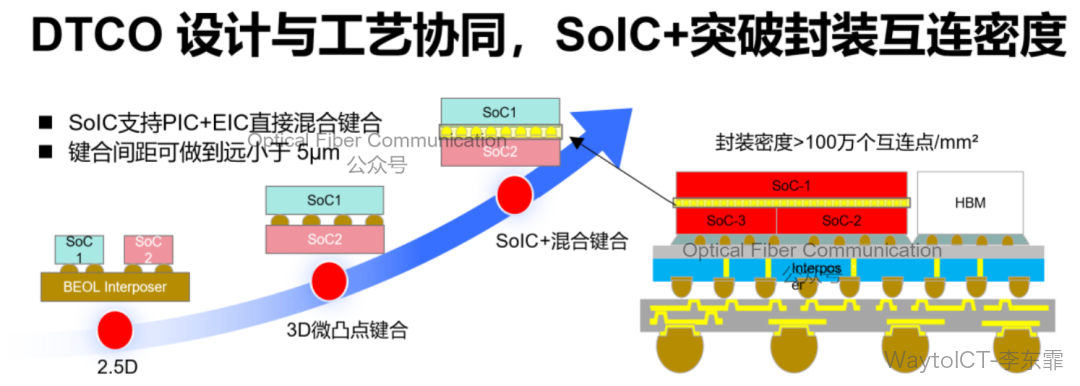
2.5D/3D 集成的关键是微凸点间距微缩。CoWoS 缩小凸点间距,提升带宽密度和能效。SoIC 凸点间距降到约 4.5 微米,带宽密度提升 4 倍,功耗明显降低。
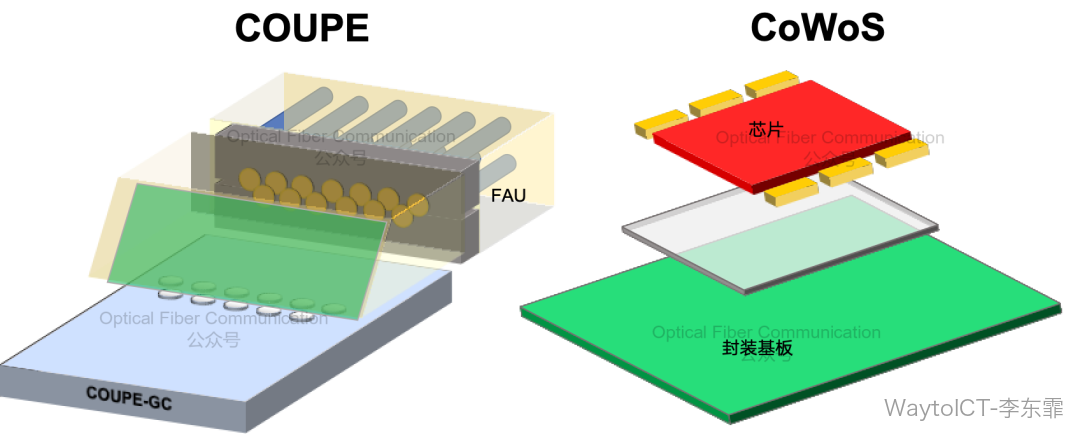
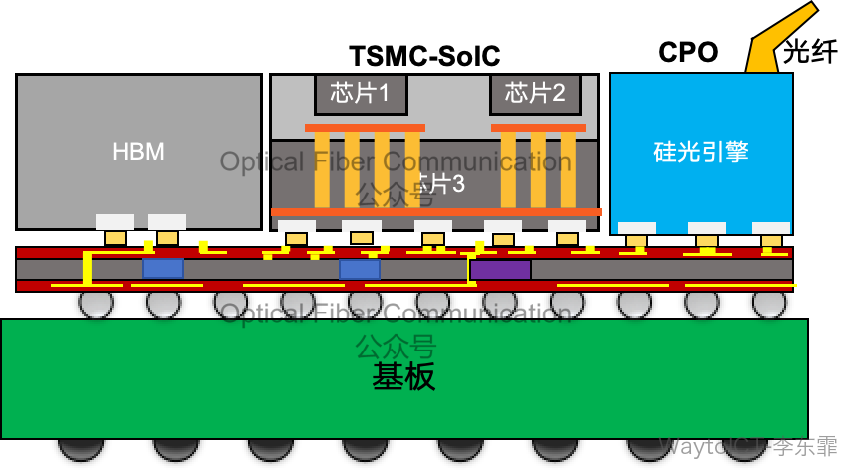
台积电:基于 COUPE 与 CoWoS 封装的 CPO 演进路线,COUPE 光引擎集成硅光技术,光互连比电互连能效提升 5 到 10 倍,延迟降低 10 到 20 倍。
不过,算力密度提升带来供电和散热难题。供电方面,MIM 电容和 eDDC 将电容密度提升超过 10 倍,有效抑制电压波动。散热方面,优化封装材料和结构,热阻最高降低 40%,保证高负载稳定运行。
最后总结,台积电推动两件事:3D IC 设计标准化和 AI 自动化设计。新的”3D 模块”设计体系简化了 3D IC 研发流程,生态协作更顺畅,同时推动 IEEE 标准。结合生成式 AI 与智能体优化技术,能大幅提升芯片与封装协同设计的效率和扩展能力。
推荐阅读
- 台积电:用于 CPO 的硅光器件性能与工艺平台
- 台积电:基于硅光TDV工艺的CPO封装流程
- 三星:CPO 硅光平台的最新性能与演进路线
- 意法半导体:支持 NPO/CPO 的硅光工艺平台进展
感谢阅读。
若有不准确的地方请指正。
光芯片、光器件、光模块(OFC2026)报告汇编,采用彩色打印和 A4 装订,上下两册共计~525 页,~20万字。有需要欢迎联系订购,价格实惠!
Enjoy this article?
Subscribe to get new optical communication insights delivered to your inbox. Free, unsubscribe anytime.